Domain daten-sammeln.de kaufen?
Wir ziehen mit dem Projekt
daten-sammeln.de um.
Sind Sie am Kauf der Domain
daten-sammeln.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain daten-sammeln.de kaufen?
Wie kann man effektiv Daten aus dem Web extrahieren und analysieren?
1. Verwenden Sie Web-Scraping-Tools wie BeautifulSoup oder Scrapy, um Daten von Websites zu extrahieren. 2. Speichern Sie die extrahierten Daten in einer Datenbank oder einem Spreadsheet, um sie zu analysieren. 3. Nutzen Sie Data-Analytics-Tools wie Python, R oder Tableau, um die Daten zu visualisieren und Erkenntnisse zu gewinnen. **
Wie kann Web-Crawling genutzt werden, um große Mengen von Web-Daten effizient zu durchsuchen und zu extrahieren?
Web-Crawling kann genutzt werden, um automatisiert das Internet nach relevanten Informationen zu durchsuchen. Durch die Verwendung von Crawling-Algorithmen können große Mengen von Webseiten in kurzer Zeit durchsucht werden. Die extrahierten Daten können dann analysiert und für verschiedene Zwecke verwendet werden. **

Ähnliche Suchbegriffe für Springer-Reasoning-Web-Web
Top-Angebote
Produkte zum Begriff Springer-Reasoning-Web-Web:
-
Panchekha, Pavel: Web Browser EngineeringWeb Browser Engineering , A working or budding software engineer always benefits from deeply understanding the platform their code runs on, and web browsers are the most common and widely-used platform there is. This book is the essential description of how they work and how that impacts web developers and other software engineers whose work touches the web. Readers of Web Browser Engineering will join the authors in building their own web browser, including rich visual effects, multithreaded architecture, JavaScript APIs, and comprehensive security policies. Web browser engines are filled with unique challenges, interesting algorithms, and clever optimizations. Building a browser is both easy and incredibly hard, both intentional and accidental, and everywhere you look, you see the evolution and history of the web wrapped up in one codebase. It's both fun, and endlessly interesting. This interactive and engaging book will be a unique source for any software engineer, computer scientist, web developer, or simply anyone with an interest in web browsers and how they work. This is an open access title available under the terms of a CC BY-NC-ND 4.0 International licence. It is free to read on the Oxford Academic platform and offered as a free PDF download from OUP and selected open access locations. , > , Erscheinungsjahr: 20241107, Produktform: Kartoniert, Autoren: Harrelson, Chris~Panchekha, Pavel, Seitenzahl/Blattzahl: 528, Themenüberschrift: COMPUTERS / Programming / General, Fachschema: Programmiersprachen, Fachkategorie: Programmier- und Skriptsprachen, allgemein, Warengruppe: TB/Programmiersprachen, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 234, Breite: 156, Höhe: 25, Gewicht: 860, Produktform: Kartoniert, Genre: Importe,47,42 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie können Web-Crawling-Technologien genutzt werden, um Informationen aus dem Internet zu extrahieren und zu analysieren? Welche Vorteile bietet Web-Crawling bei der Sammlung von Daten aus dem World Wide Web?
Web-Crawling-Technologien durchsuchen automatisch das Internet nach relevanten Informationen, extrahieren diese und speichern sie in einer Datenbank. Durch die kontinuierliche Aktualisierung der gesammelten Daten können Trends und Muster identifiziert und analysiert werden. Dies ermöglicht Unternehmen, fundierte Entscheidungen auf der Grundlage aktueller Informationen zu treffen und Wettbewerbsvorteile zu erlangen. **
-
Wie werden Web-Crawling-Tools verwendet, um Daten aus dem Internet zu extrahieren und zu analysieren?
Web-Crawling-Tools durchsuchen automatisch das Internet nach bestimmten Inhalten, indem sie Websites nach Links und Informationen scannen. Die extrahierten Daten werden dann gesammelt und in einer strukturierten Form gespeichert. Anschließend können diese Daten analysiert werden, um Trends, Muster oder Informationen zu identifizieren. **
-
Was sind die grundlegenden Unterschiede zwischen Webarten wie Web 1.0, Web 2.0 und Web 3.0?
Web 1.0 war statisch und einseitig mit reinen Informationsseiten, Web 2.0 ermöglichte Interaktion und Benutzerbeteiligung durch soziale Medien und Blogs, Web 3.0 konzentriert sich auf personalisierte Inhalte, maschinelles Lernen und künstliche Intelligenz für eine individualisierte Nutzererfahrung. **
-
Wie lautet der Oberbegriff für die folgenden Dinge: Deep Web, Darknet, World Wide Web, Web?
Der Oberbegriff für die genannten Dinge ist "Internet". Das Deep Web bezieht sich auf den Teil des Internets, der nicht über Suchmaschinen zugänglich ist, während das Darknet auf anonyme Kommunikation und den Zugang zu illegalen Inhalten abzielt. Das World Wide Web ist der öffentliche Teil des Internets, in dem Websites und Webseiten zugänglich sind. **

Wie kann man WhatsApp Web Chatverläufe speichern?
Um WhatsApp Web Chatverläufe zu speichern, kannst du Screenshots von den einzelnen Chats machen oder die Chatverläufe als Textdateien exportieren. Dazu gehst du in den jeweiligen Chat, öffnest das Menü und wählst entweder "Screenshot machen" oder "Chat exportieren" aus. Beachte jedoch, dass Screenshots nur einzelne Nachrichten anzeigen und bei längeren Chats unpraktisch sein können. **
Wie kann man Daten beim Web Scraping in Python effektiv speichern?
Um Daten beim Web Scraping in Python effektiv zu speichern, gibt es mehrere Möglichkeiten. Eine Möglichkeit ist die Verwendung von CSV-Dateien, die einfach zu erstellen und zu lesen sind. Eine andere Möglichkeit ist die Verwendung von Datenbanken wie SQLite oder MySQL, um die Daten strukturiert zu speichern und effizient darauf zuzugreifen. Eine weitere Option ist die Verwendung von JSON-Dateien, um die Daten im JSON-Format zu speichern, was besonders nützlich ist, wenn die Daten für den Austausch mit anderen Systemen verwendet werden sollen. **
Top-Angebote
Produkte zum Begriff Springer-Reasoning-Web-Web:
-
Panchekha, Pavel: Web Browser EngineeringWeb Browser Engineering , A working or budding software engineer always benefits from deeply understanding the platform their code runs on, and web browsers are the most common and widely-used platform there is. This book is the essential description of how they work and how that impacts web developers and other software engineers whose work touches the web. Readers of Web Browser Engineering will join the authors in building their own web browser, including rich visual effects, multithreaded architecture, JavaScript APIs, and comprehensive security policies. Web browser engines are filled with unique challenges, interesting algorithms, and clever optimizations. Building a browser is both easy and incredibly hard, both intentional and accidental, and everywhere you look, you see the evolution and history of the web wrapped up in one codebase. It's both fun, and endlessly interesting. This interactive and engaging book will be a unique source for any software engineer, computer scientist, web developer, or simply anyone with an interest in web browsers and how they work. This is an open access title available under the terms of a CC BY-NC-ND 4.0 International licence. It is free to read on the Oxford Academic platform and offered as a free PDF download from OUP and selected open access locations. , > , Erscheinungsjahr: 20241107, Produktform: Kartoniert, Autoren: Harrelson, Chris~Panchekha, Pavel, Seitenzahl/Blattzahl: 528, Themenüberschrift: COMPUTERS / Programming / General, Fachschema: Programmiersprachen, Fachkategorie: Programmier- und Skriptsprachen, allgemein, Warengruppe: TB/Programmiersprachen, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 234, Breite: 156, Höhe: 25, Gewicht: 860, Produktform: Kartoniert, Genre: Importe,47,42 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann man effektiv Daten aus dem Web extrahieren und analysieren?
1. Verwenden Sie Web-Scraping-Tools wie BeautifulSoup oder Scrapy, um Daten von Websites zu extrahieren. 2. Speichern Sie die extrahierten Daten in einer Datenbank oder einem Spreadsheet, um sie zu analysieren. 3. Nutzen Sie Data-Analytics-Tools wie Python, R oder Tableau, um die Daten zu visualisieren und Erkenntnisse zu gewinnen. **
-
Wie kann Web-Crawling genutzt werden, um große Mengen von Web-Daten effizient zu durchsuchen und zu extrahieren?
Web-Crawling kann genutzt werden, um automatisiert das Internet nach relevanten Informationen zu durchsuchen. Durch die Verwendung von Crawling-Algorithmen können große Mengen von Webseiten in kurzer Zeit durchsucht werden. Die extrahierten Daten können dann analysiert und für verschiedene Zwecke verwendet werden. **
-
Wie können Web-Crawling-Technologien genutzt werden, um Informationen aus dem Internet zu extrahieren und zu analysieren? Welche Vorteile bietet Web-Crawling bei der Sammlung von Daten aus dem World Wide Web?
Web-Crawling-Technologien durchsuchen automatisch das Internet nach relevanten Informationen, extrahieren diese und speichern sie in einer Datenbank. Durch die kontinuierliche Aktualisierung der gesammelten Daten können Trends und Muster identifiziert und analysiert werden. Dies ermöglicht Unternehmen, fundierte Entscheidungen auf der Grundlage aktueller Informationen zu treffen und Wettbewerbsvorteile zu erlangen. **
-
Wie werden Web-Crawling-Tools verwendet, um Daten aus dem Internet zu extrahieren und zu analysieren?
Web-Crawling-Tools durchsuchen automatisch das Internet nach bestimmten Inhalten, indem sie Websites nach Links und Informationen scannen. Die extrahierten Daten werden dann gesammelt und in einer strukturierten Form gespeichert. Anschließend können diese Daten analysiert werden, um Trends, Muster oder Informationen zu identifizieren. **
Ähnliche Suchbegriffe für Springer-Reasoning-Web-Web
-
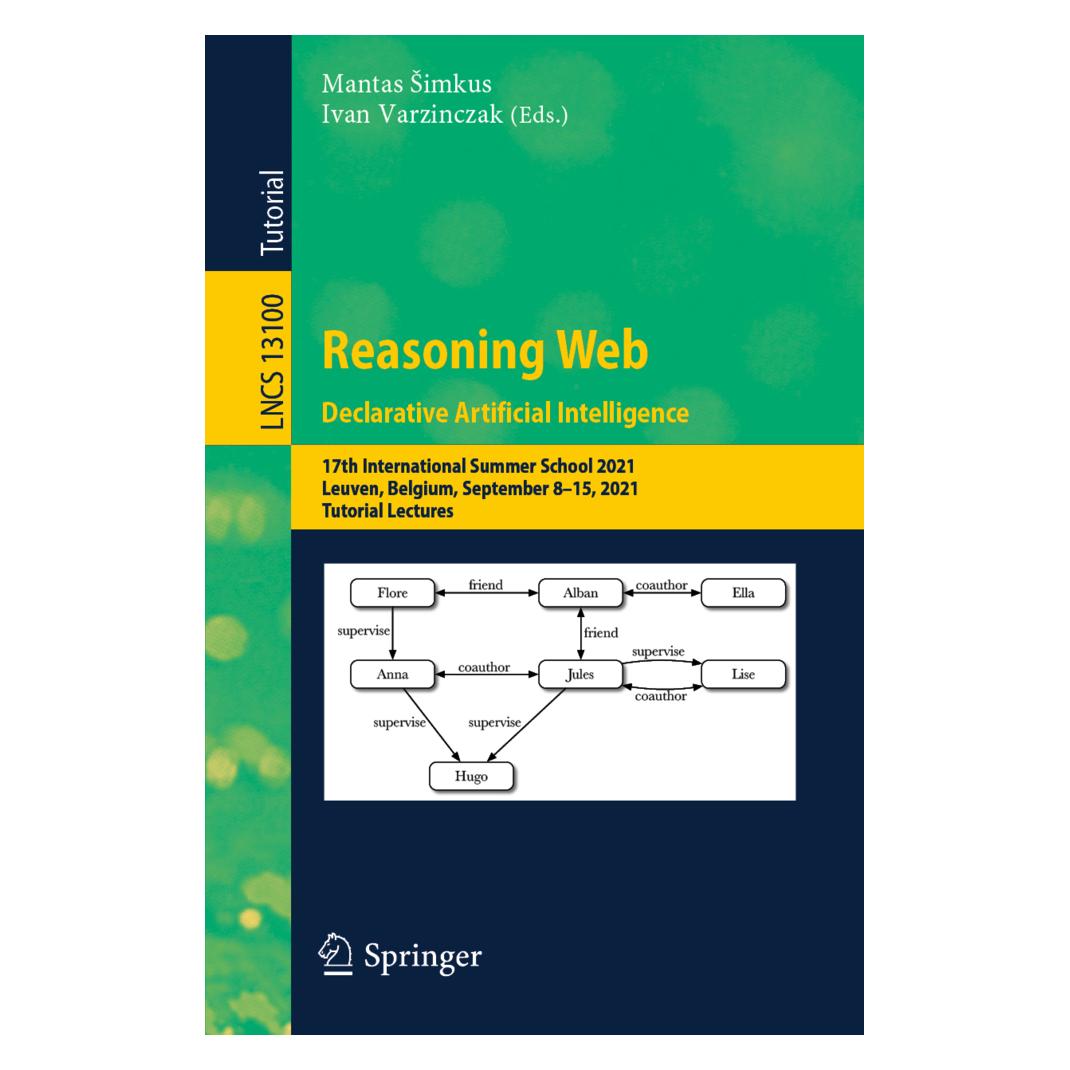
Springer Reasoning Web. Declarative Artificial Intelligence (Englisch, Softcover, Ivan Varzinczak, Mantas Simkus) (56229081)Springer Reasoning Web. Declarative Artificial Intelligence (Englisch, Softcover, Ivan Varzinczak, Mantas Simkus) (56229081)85,59 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Unterschiede zwischen Webarten wie Web 1.0, Web 2.0 und Web 3.0?
Web 1.0 war statisch und einseitig mit reinen Informationsseiten, Web 2.0 ermöglichte Interaktion und Benutzerbeteiligung durch soziale Medien und Blogs, Web 3.0 konzentriert sich auf personalisierte Inhalte, maschinelles Lernen und künstliche Intelligenz für eine individualisierte Nutzererfahrung. **
-
Wie lautet der Oberbegriff für die folgenden Dinge: Deep Web, Darknet, World Wide Web, Web?
Der Oberbegriff für die genannten Dinge ist "Internet". Das Deep Web bezieht sich auf den Teil des Internets, der nicht über Suchmaschinen zugänglich ist, während das Darknet auf anonyme Kommunikation und den Zugang zu illegalen Inhalten abzielt. Das World Wide Web ist der öffentliche Teil des Internets, in dem Websites und Webseiten zugänglich sind. **
-
Wie kann man WhatsApp Web Chatverläufe speichern?
Um WhatsApp Web Chatverläufe zu speichern, kannst du Screenshots von den einzelnen Chats machen oder die Chatverläufe als Textdateien exportieren. Dazu gehst du in den jeweiligen Chat, öffnest das Menü und wählst entweder "Screenshot machen" oder "Chat exportieren" aus. Beachte jedoch, dass Screenshots nur einzelne Nachrichten anzeigen und bei längeren Chats unpraktisch sein können. **
-
Wie kann man Daten beim Web Scraping in Python effektiv speichern?
Um Daten beim Web Scraping in Python effektiv zu speichern, gibt es mehrere Möglichkeiten. Eine Möglichkeit ist die Verwendung von CSV-Dateien, die einfach zu erstellen und zu lesen sind. Eine andere Möglichkeit ist die Verwendung von Datenbanken wie SQLite oder MySQL, um die Daten strukturiert zu speichern und effizient darauf zuzugreifen. Eine weitere Option ist die Verwendung von JSON-Dateien, um die Daten im JSON-Format zu speichern, was besonders nützlich ist, wenn die Daten für den Austausch mit anderen Systemen verwendet werden sollen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.